AI ซิงโครไนซ์ริมฝาก
Lip sync AI ทำให้ปากเคลื่อนไหวใหม่เพื่อให้ตรงกับแทร็กเสียงใหม่ ซึ่งขับเคลื่อนเวิร์กโฟลว์สองแบบ: ดับบิ้งวิดีโอที่มีอยู่ด้วยเสียงพูดที่แตกต่างกัน และทำให้รูปถ่ายเดียวเป็นวิดีโอพูดคุยแบบเต็ม สตูดิโอ avatar ของ Arteza โฮสต์เอนจิน lip sync หลายตัว ตั้งแต่ดับบิ้งวิดีโอ 4K ของ Sync-3 ไปจนถึง avatar รูปถ่ายบวกเสียงของ OmniHuman ภายใต้ยอดเครดิตเดียว
การเคลื่อนไหวของริมฝีปากบน Arteza
ภาพบุคคลที่ถูกขับเคลื่อนด้วยเสียง วางเมาส์หรือแตะเพื่อดูริมฝีปากเคลื่อนไหวตามการพูด
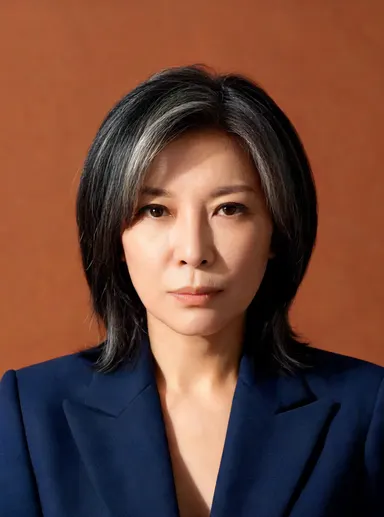 OmniHuman v1.5 3c
Studio portrait of a 40-year-old Japanese woman with silver-streaked bob, wearing a structured indigo blazer, warm terracotta backdrop, soft butterfly lighting, photorealistic, shoulders-up framing, direct confident gaze.
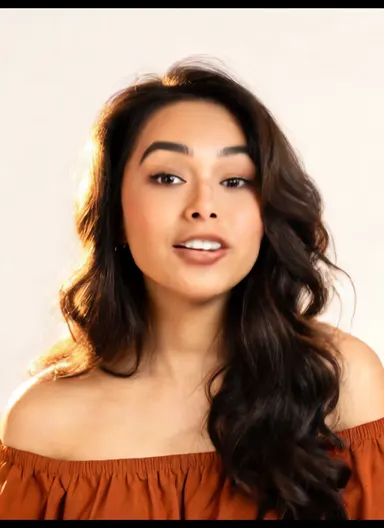 Wan 2.2 S2V 4c
Studio portrait of a 25-year-old Peruvian woman with long dark waves, wearing an off-shoulder rust-orange blouse, ivory backdrop, golden-hour rim lighting, photorealistic, shoulders-up, bright curious expression.
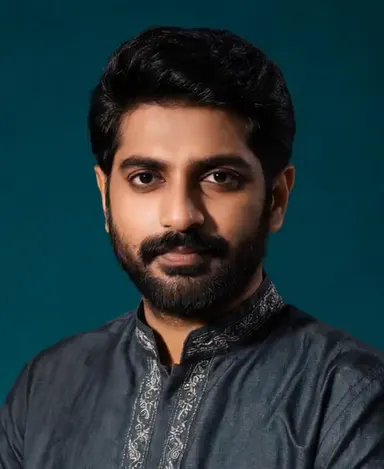 Infini Talk 5c
Studio portrait of a 38-year-old Indian man with neat beard, wearing a charcoal kurta with subtle embroidery, deep teal backdrop, split studio lighting, photorealistic, shoulders-up, composed and attentive expression.
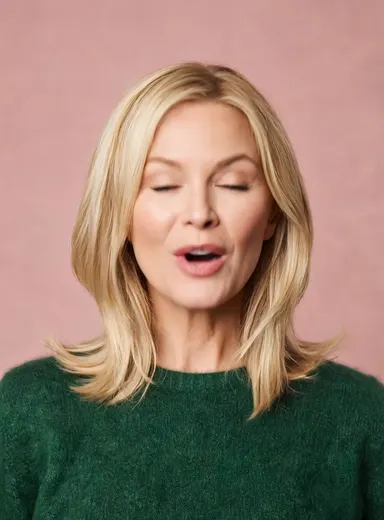 Fabric 1.0 2c
Studio portrait of a 45-year-old Swedish woman with blonde lob haircut, wearing a forest-green cashmere sweater, dusty rose backdrop, soft beauty-dish lighting, photorealistic, shoulders-up, genuine warm gaze.
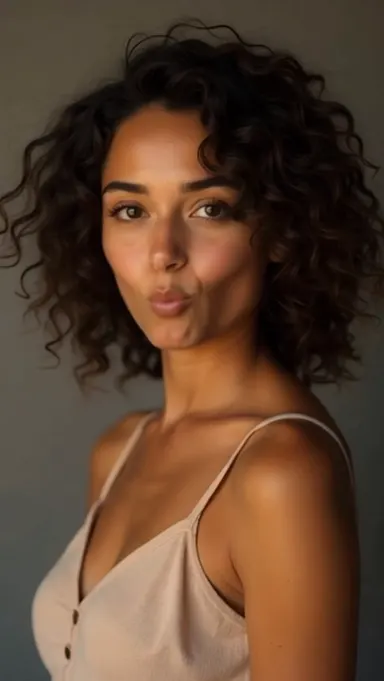 Sync-3 Lipsync 3c
Studio portrait of a 32-year-old South Korean man with undercut hair, wearing a crisp sky-blue dress shirt, off-white backdrop, cool cinematic LED lighting, photorealistic, shoulders-up, relaxed professional expression.
 SadTalker 8c
Studio portrait of a 55-year-old Brazilian woman with silver curls, wearing a deep burgundy turtleneck, slate-grey backdrop, soft front-fill studio lighting, photorealistic, shoulders-up, thoughtful neutral expression.
วิธีการทำงาน
ให้ใบหน้า
อัปโหลดวิดีโอเพื่อดับบิ้ง หรือรูปถ่ายเหมือนใบหน้าเดียวเพื่อทำให้เคลื่อนไหว ใบหน้าที่หันไปข้างหน้า มีแสงสว่างดี และปากมองเห็นชัดเจนจะซิงค์ได้น่าเชื่อถือที่สุด
เพิ่มเสียง
อัปโหลดการบันทึก หรือสร้างเสียงพูดก่อนในสตูดิโอเสียงด้วยการแปลงข้อความเป็นเสียงหรือเสียงโคลน โมเดลจะแมปเสียงพูดแต่ละเสียงกับรูปร่างปากที่ตรงกัน
สร้างวิดีโอที่ซิงค์แล้ว
โมเดลจะสร้างบริเวณปากใหม่ทีละเฟรม หรือทำให้ใบหน้าทั้งหมดเคลื่อนไหวจากรูปถ่าย เพื่อให้ริมฝีปาก กรรม และสำนวนเคลื่อนไหวตรงกับเสียง
โมเดลที่คุณสามารถใช้งานได้ทันที
โมเดลด้านล่างทั้งหมดพร้อมใช้งานบน Arteza โดยมีค่าใช้จ่ายเครดิตปัจจุบัน ดึงมาจากเอ็นจินการกำหนดราคาเดียวกันกับที่สตูดิโอใช้ในขณะสร้างผลงาน
คำถามที่พบบ่อย
ฉันสามารถ lip sync รูปถ่ายได้หรือต้องใช้วิดีโอ
รองรับเวิร์กโฟลว์ทั้งสองแบบ Sync-3 Lipsync ดับบิ้งวิดีโอที่มีอยู่ด้วยเสียงใหม่ได้ถึง 4K OmniHuman v1.5, Kling Avatar v2 และ Infini Talk ทำให้รูปถ่ายเดียวบวกไฟล์เสียงเป็นวิดีโอพูดคุยที่สมบูรณ์
AI lip sync ทำงานในภาษาใดๆ ได้หรือไม่
โดยทั่วไปใช่ โมเดลจะแมปเสียงกับรูปร่างปากแทนที่จะเข้าใจคำพูด ดังนั้นจึงสามารถซิงค์ปากกับภาษาพูดส่วนใหญ่ได้ ซึ่งเป็นเหตุผลว่าทำไม lip sync จึงเป็นหลักสำคัญของการแปลวิดีโอและเนื้อหาที่ปรับให้เหมาะสมกับท้องถิ่น
อินพุตใดให้ผลลัพธ์ที่ดีที่สุด
เสียงพูดที่สะอาดโดยไม่มีเพลงหนัก และใบหน้าที่มีขนาดค่อนข้างใหญ่ หันไปข้างหน้า และไม่มีสิ่งกีดขวาง การหันหัวอย่างรวดเร็ว มือปิดปาก และมุมที่รุนแรงคือที่ที่ artifacts ปรากฏขึ้น
ฉันสามารถใช้ใบหน้าของคนอื่นได้หรือไม่
เฉพาะด้วยความยินยอมของพวกเขา Lip sync ใช้กันอย่างแพร่หลายสำหรับดับบิ้ง การแปล และเนื้อหา avatar ที่ถูกต้องตามกฎหมาย แต่คุณควรทำให้เคลื่อนไหวเฉพาะลักษณะของคนที่ยินยอมเท่านั้น