همزمانی لب هوشمند
هوش مصنوعی همزمانی لب دهان را دوباره متحرک میکند تا با یک مسیر صوتی جدید مطابقت داشته باشد. این فناوری دو کاربرد را فراهم میکند: دوبله کردن ویدیوی موجود با گفتار متفاوت و متحرک کردن یک عکس منفرد به یک ویدیوی کامل صحبتکننده. استودیوی آواتار Arteza چندین موتور همزمانی لب را میزبانی میکند، از دوبله ویدیوی 4K در Sync-3 تا آواتارهای عکسبهصدای OmniHuman، همه تحت یک موجودی اعتباری.
همزمانی لبها در Arteza
یک پورترت که توسط یک پیشنما صوتی کنترل میشود. با حرکت نگریز یا لمس، دهان را دنبال کنید.
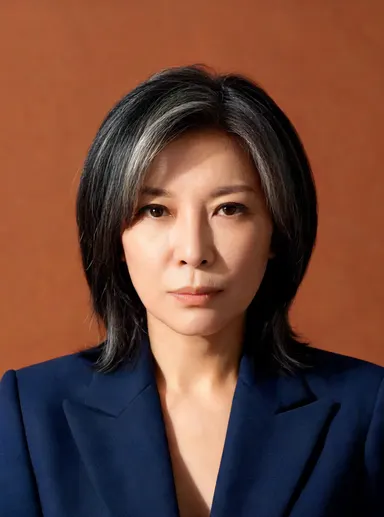 OmniHuman v1.5 3c
Studio portrait of a 40-year-old Japanese woman with silver-streaked bob, wearing a structured indigo blazer, warm terracotta backdrop, soft butterfly lighting, photorealistic, shoulders-up framing, direct confident gaze.
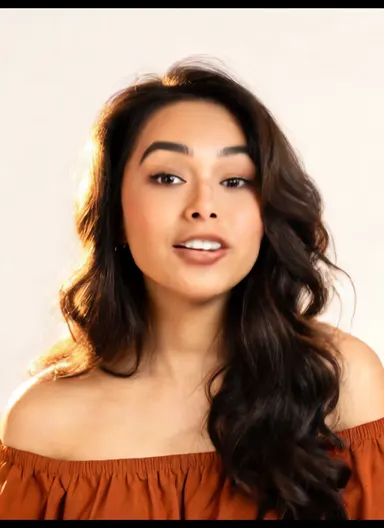 Wan 2.2 S2V 4c
Studio portrait of a 25-year-old Peruvian woman with long dark waves, wearing an off-shoulder rust-orange blouse, ivory backdrop, golden-hour rim lighting, photorealistic, shoulders-up, bright curious expression.
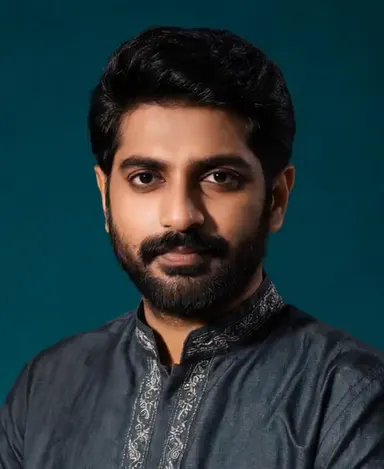 Infini Talk 5c
Studio portrait of a 38-year-old Indian man with neat beard, wearing a charcoal kurta with subtle embroidery, deep teal backdrop, split studio lighting, photorealistic, shoulders-up, composed and attentive expression.
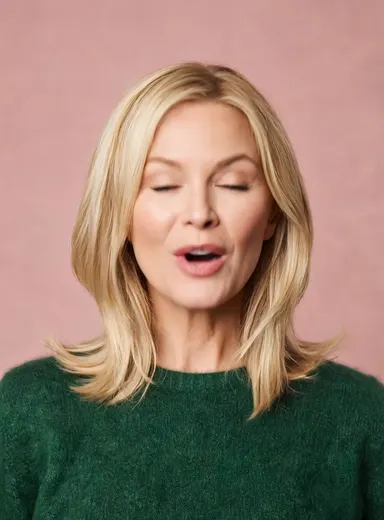 Fabric 1.0 2c
Studio portrait of a 45-year-old Swedish woman with blonde lob haircut, wearing a forest-green cashmere sweater, dusty rose backdrop, soft beauty-dish lighting, photorealistic, shoulders-up, genuine warm gaze.
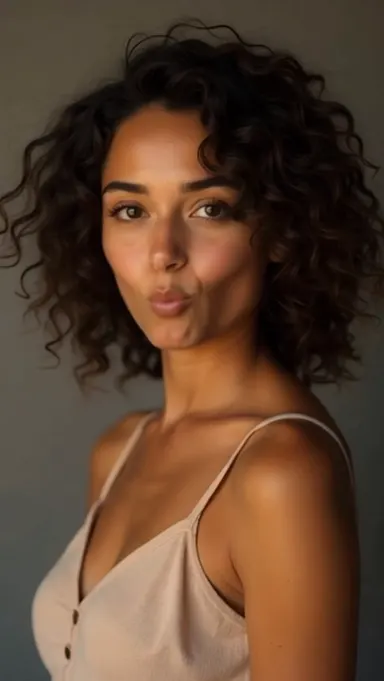 Sync-3 Lipsync 3c
Studio portrait of a 32-year-old South Korean man with undercut hair, wearing a crisp sky-blue dress shirt, off-white backdrop, cool cinematic LED lighting, photorealistic, shoulders-up, relaxed professional expression.
 SadTalker 8c
Studio portrait of a 55-year-old Brazilian woman with silver curls, wearing a deep burgundy turtleneck, slate-grey backdrop, soft front-fill studio lighting, photorealistic, shoulders-up, thoughtful neutral expression.
نحوه عملکرد
چهره را ارائه دهید
یک ویدیو برای دوبله یا یک عکس پرتره منفرد برای متحرک کردن آپلود کنید. چهرههای روبهرو، روشنشده خوب با دهان بهوضوح قابلرؤیت بهترین نتایج را دارند.
صدا را اضافه کنید
یک ضبط آپلود کنید یا ابتدا صدا را در استودیوی صوتی با تبدیل متن به گفتار یا صدای شبیهسازیشده تولید کنید. مدل هر صدای گفتاری را به شکل دهان مطابق نقشهبرداری میکند.
ویدیوی همزمان را تولید کنید
مدل منطقه دهان را فریم به فریم دوباره تولید میکند یا کل چهره را از عکس متحرک میکند، بنابراین لبها، فک و تعابیر صورت با صدا همزمان حرکت میکنند.
مدلهایی که میتوانید همین الان استفاده کنید
هر مدلی که در زیر مشاهده میکنید در Arteza فعال است و هزینه اعتبار فعلی آن، از همان موتور قیمتگذاری که استودیو هنگام تولید استفاده میکند، دریافت شده است.
پرسشهای متداول
آیا میتوانم لبهای یک عکس را همزمان کنم یا به ویدیو نیاز دارم؟
هر دو کاربرد پشتیبانی میشوند. Sync-3 Lipsync ویدیوهای موجود را با صدای جدید تا 4K دوبله میکند. OmniHuman v1.5، Kling Avatar v2 و Infini Talk یک عکس منفرد بهعلاوه یک فایل صوتی را به یک ویدیوی صحبتکننده کامل متحرک میکنند.
آیا همزمانی لب هوشمند در هر زبانی کار میکند؟
عموماً بله. مدل صداها را به شکلهای دهان نقشهبرداری میکند نه درک کلمات، بنابراین میتواند دهانها را با اکثر زبانهای گفتاری همزمان کند، که همین دلیل است که همزمانی لب ستون فقرات ترجمه ویدیو و محتوای محلیشده است.
کدام ورودیها بهترین نتایج را میدهند؟
صدای گفتار تمیز بدون موسیقی سنگین و چهرهای که نسبتاً بزرگ، روبهرو و بدون مانع باشد. چرخش سر سریع، دستها روی دهان و زوایای شدید جایی هستند که نقصها ظاهر میشوند.
آیا میتوانم از چهره شخص دیگری استفاده کنم؟
فقط با رضایت آنها. همزمانی لب بهطور گسترده برای دوبله، ترجمه و محتوای آواتار قانونی استفاده میشود، اما شما فقط باید شباهت افرادی را متحرک کنید که با آن موافقت کردهاند.