Artezaでリップシンク
オーディオトラックによって駆動される肖像画。ホバーまたはタップして、口が発話に合わせて動く様子を確認してください。
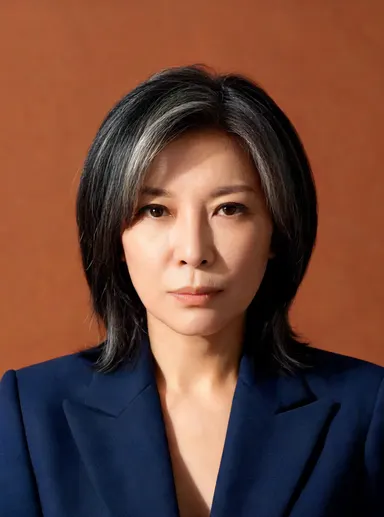 OmniHuman v1.5 3c
Studio portrait of a 40-year-old Japanese woman with silver-streaked bob, wearing a structured indigo blazer, warm terracotta backdrop, soft butterfly lighting, photorealistic, shoulders-up framing, direct confident gaze.
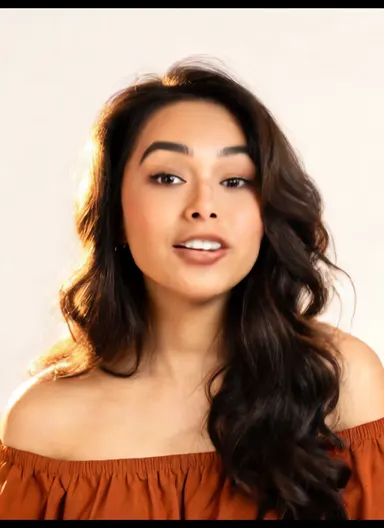 Wan 2.2 S2V 4c
Studio portrait of a 25-year-old Peruvian woman with long dark waves, wearing an off-shoulder rust-orange blouse, ivory backdrop, golden-hour rim lighting, photorealistic, shoulders-up, bright curious expression.
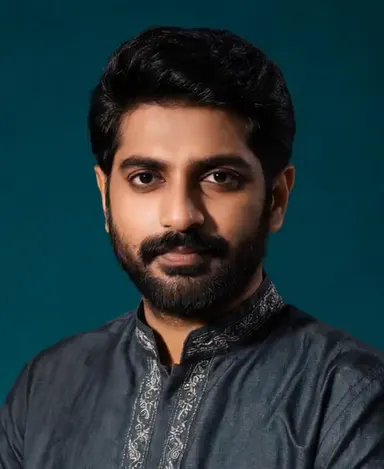 Infini Talk 5c
Studio portrait of a 38-year-old Indian man with neat beard, wearing a charcoal kurta with subtle embroidery, deep teal backdrop, split studio lighting, photorealistic, shoulders-up, composed and attentive expression.
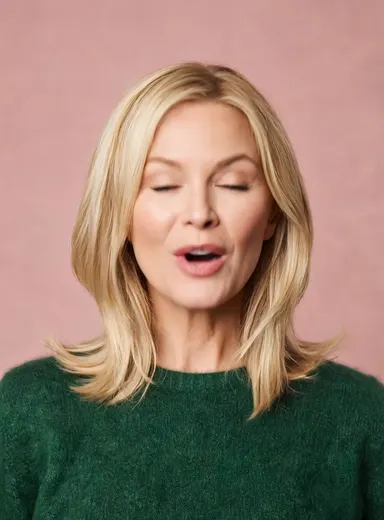 Fabric 1.0 2c
Studio portrait of a 45-year-old Swedish woman with blonde lob haircut, wearing a forest-green cashmere sweater, dusty rose backdrop, soft beauty-dish lighting, photorealistic, shoulders-up, genuine warm gaze.
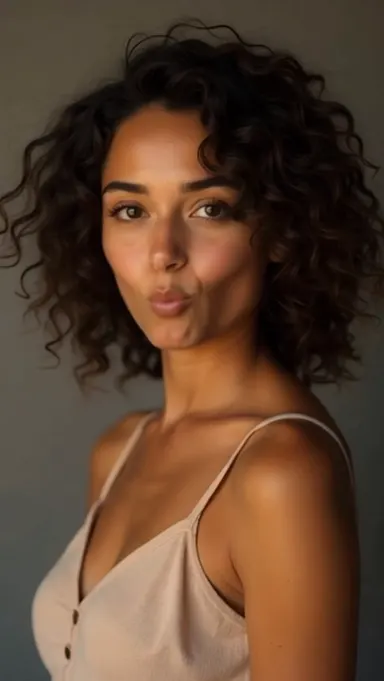 Sync-3 Lipsync 3c
Studio portrait of a 32-year-old South Korean man with undercut hair, wearing a crisp sky-blue dress shirt, off-white backdrop, cool cinematic LED lighting, photorealistic, shoulders-up, relaxed professional expression.
 SadTalker 8c
Studio portrait of a 55-year-old Brazilian woman with silver curls, wearing a deep burgundy turtleneck, slate-grey backdrop, soft front-fill studio lighting, photorealistic, shoulders-up, thoughtful neutral expression.
仕組み
顔を提供する
吹き替え用のビデオ、またはアニメーション化する1枚の肖像写真をアップロードしてください。正面を向いた、よく照らされた、口がはっきり見える顔が最も説得力のある同期を実現します。
オーディオを追加する
録音をアップロードするか、オーディオスタジオでテキスト音声合成またはクローンボイスを使用して音声を生成してください。モデルは各音声音を対応する口の形にマッピングします。
同期されたビデオを生成する
モデルは口の領域をフレームごとに再生成するか、写真から顔全体をアニメーション化するため、唇、顎、表情が音に合わせて動きます。
今すぐ使えるモデル
以下の各モデルは、スタジオで使用されているのと同じ価格エンジンから現在のクレジットコストを取得して、Artezaでライブ配信されています。
よくある質問
写真をリップシンクできますか、それともビデオが必要ですか?
両方のワークフローがサポートされています。Sync-3 Lipsyncは既存のビデオを最大4Kで新しいオーディオで吹き替えます。OmniHuman v1.5、Kling Avatar v2、Infini Talkは1枚の写真とオーディオファイルを完全なしゃべる動画にアニメーション化します。
AI リップシンクはあらゆる言語で機能しますか?
一般的にはい。モデルは単語を理解するのではなく音を口の形にマッピングするため、ほとんどの話し言葉に口を同期できます。これがリップシンクがビデオ翻訳とローカライズされたコンテンツの基盤である理由です。
最良の結果を得るにはどのような入力が必要ですか?
クリーンな音声オーディオ(ヘビーな音楽なし)と、合理的に大きく、正面を向いた、妨げられていない顔です。急速な頭の回転、口を覆う手、極端な角度はアーティファクトが現れる場所です。
他の人の顔を使用できますか?
同意がある場合のみです。リップシンクは正当な吹き替え、翻訳、アバターコンテンツに広く使用されていますが、同意した人の容貌のみをアニメーション化する必要があります。