AI लिप सिंक
लिप सिंक AI मुंह को फिर से एनिमेट करता है ताकि वह नए ऑडियो ट्रैक से मेल खाए, जो दो वर्कफ़्लो को शक्ति देता है: मौजूदा वीडियो को विभिन्न भाषण के साथ डब करना, और एक फोटो को पूर्ण बोलते हुए वीडियो में एनिमेट करना। Arteza का अवतार स्टूडियो कई लिप सिंक इंजन होस्ट करता है, Sync-3 के 4K वीडियो डबिंग से लेकर OmniHuman के फोटो-प्लस-ऑडियो अवतार तक, एक क्रेडिट बैलेंस के तहत।
लिप सिंक किया गया Arteza पर
एक ऑडियो ट्रैक द्वारा चलाया गया पोर्ट्रेट। होवर या टैप करें और देखें कि मुंह कैसे बोल के साथ बराबर होता है।
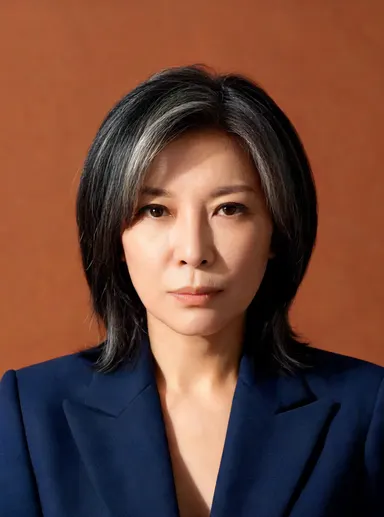 OmniHuman v1.5 3c
Studio portrait of a 40-year-old Japanese woman with silver-streaked bob, wearing a structured indigo blazer, warm terracotta backdrop, soft butterfly lighting, photorealistic, shoulders-up framing, direct confident gaze.
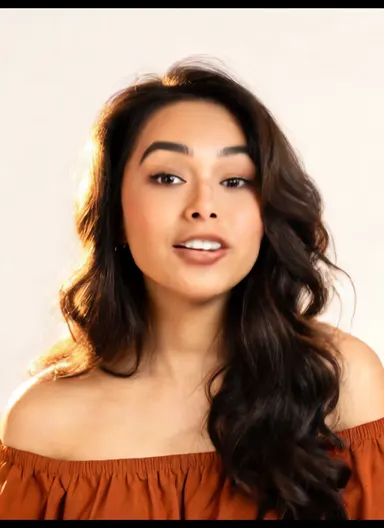 Wan 2.2 S2V 4c
Studio portrait of a 25-year-old Peruvian woman with long dark waves, wearing an off-shoulder rust-orange blouse, ivory backdrop, golden-hour rim lighting, photorealistic, shoulders-up, bright curious expression.
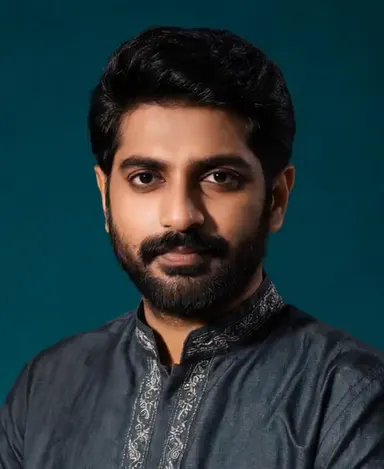 Infini Talk 5c
Studio portrait of a 38-year-old Indian man with neat beard, wearing a charcoal kurta with subtle embroidery, deep teal backdrop, split studio lighting, photorealistic, shoulders-up, composed and attentive expression.
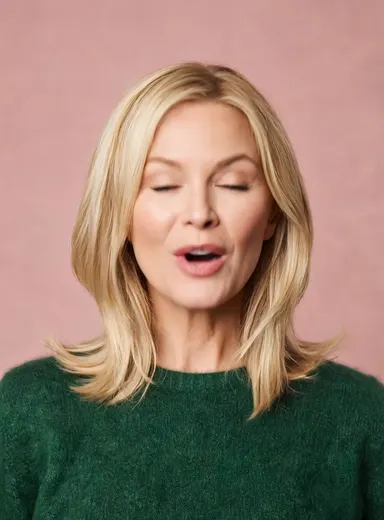 Fabric 1.0 2c
Studio portrait of a 45-year-old Swedish woman with blonde lob haircut, wearing a forest-green cashmere sweater, dusty rose backdrop, soft beauty-dish lighting, photorealistic, shoulders-up, genuine warm gaze.
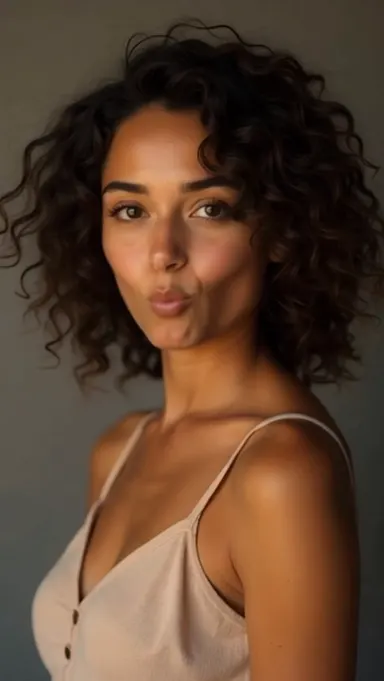 Sync-3 Lipsync 3c
Studio portrait of a 32-year-old South Korean man with undercut hair, wearing a crisp sky-blue dress shirt, off-white backdrop, cool cinematic LED lighting, photorealistic, shoulders-up, relaxed professional expression.
 SadTalker 8c
Studio portrait of a 55-year-old Brazilian woman with silver curls, wearing a deep burgundy turtleneck, slate-grey backdrop, soft front-fill studio lighting, photorealistic, shoulders-up, thoughtful neutral expression.
यह कैसे काम करता है
चेहरा प्रदान करें
डब करने के लिए एक वीडियो अपलोड करें, या एनिमेट करने के लिए एक पोर्ट्रेट फोटो अपलोड करें। सामने की ओर मुंह वाले, अच्छी रोशनी वाले चेहरे जिनमें मुंह स्पष्ट रूप से दिखाई दे, सबसे अच्छी तरह सिंक होते हैं।
ऑडियो जोड़ें
एक रिकॉर्डिंग अपलोड करें, या पहले ऑडियो स्टूडियो में टेक्स्ट टू स्पीच या क्लोन किए गए वॉयस के साथ भाषण जेनरेट करें। मॉडल प्रत्येक भाषण ध्वनि को मेल खाने वाले मुंह के आकार से मैप करता है।
सिंक किया गया वीडियो जेनरेट करें
मॉडल मुंह के क्षेत्र को फ्रेम दर फ्रेम फिर से जेनरेट करता है, या फोटो से पूरे चेहरे को एनिमेट करता है, ताकि होंठ, जबड़ा और भाव ध्वनि के साथ समय में चलें।
आप अभी उपयोग कर सकते हैं मॉडल
नीचे दिया गया प्रत्येक मॉडल Arteza पर लाइव है, जिसकी वर्तमान क्रेडिट लागत स्टूडियो द्वारा जनरेशन समय पर उपयोग किए जाने वाले समान मूल्य निर्धारण इंजन से प्राप्त की गई है।
अक्सर पूछे जाने वाले प्रश्न
क्या मैं फोटो को लिप सिंक कर सकता हूं, या मुझे वीडियो की जरूरत है?
दोनों वर्कफ़्लो समर्थित हैं। Sync-3 Lipsync मौजूदा वीडियो को 4K तक नए ऑडियो के साथ डब करता है। OmniHuman v1.5, Kling Avatar v2 और Infini Talk एक फोटो प्लस ऑडियो फाइल को एक पूर्ण बोलते हुए वीडियो में एनिमेट करते हैं।
क्या AI लिप सिंक किसी भी भाषा में काम करता है?
आम तौर पर हां। मॉडल ध्वनियों को मुंह के आकार से मैप करता है न कि शब्दों को समझता है, इसलिए यह अधिकांश बोली जाने वाली भाषाओं में मुंह को सिंक कर सकता है, यही कारण है कि लिप सिंक वीडियो अनुवाद और स्थानीयकृत सामग्री की रीढ़ है।
सर्वोत्तम परिणाम कौन से इनपुट देते हैं?
भारी संगीत के बिना स्वच्छ भाषण ऑडियो, और एक चेहरा जो उचित रूप से बड़ा, सामने की ओर और बाधा रहित हो। तेजी से सिर मुड़ना, मुंह पर हाथ और चरम कोण वह जगह हैं जहां कलाकृतियां दिखाई देती हैं।
क्या मैं किसी और के चेहरे का उपयोग कर सकता हूं?
केवल उनकी सहमति के साथ। लिप सिंक का व्यापक रूप से वैध डबिंग, अनुवाद और अवतार सामग्री के लिए उपयोग किया जाता है, लेकिन आपको केवल उन लोगों की समानता को एनिमेट करना चाहिए जिन्होंने इसके लिए सहमति दी है।