AI Lip Sync
Lip sync AI genanimerer en mund, så den passer til et nyt lydspor, hvilket muliggør to arbejdsgange: dubbing af eksisterende videoer med anden tale og animering af et enkelt foto til en fuld talende video. Artzeas avatar studio hoster flere lip sync-motorer, fra Sync-3's 4K-videodubbing til OmniHumans foto-plus-lyd-avatarer, under en fælles kreditbalance.
Lip sync på Arteza
Et portræt, der drives af en lydfil. Hold musen over eller tryk for at se mundens bevægelse følge talen.
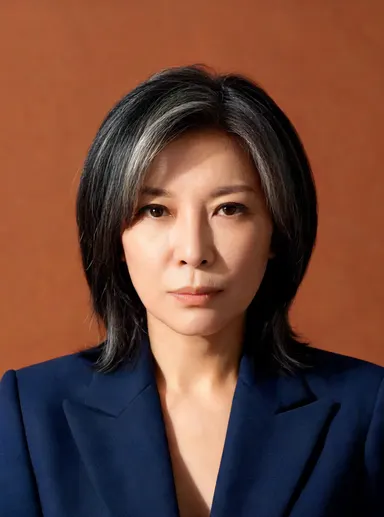 OmniHuman v1.5 3c
Studio portrait of a 40-year-old Japanese woman with silver-streaked bob, wearing a structured indigo blazer, warm terracotta backdrop, soft butterfly lighting, photorealistic, shoulders-up framing, direct confident gaze.
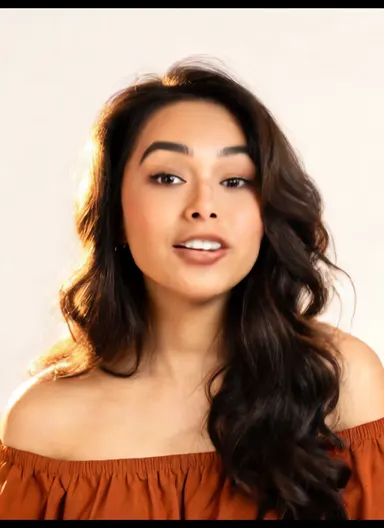 Wan 2.2 S2V 4c
Studio portrait of a 25-year-old Peruvian woman with long dark waves, wearing an off-shoulder rust-orange blouse, ivory backdrop, golden-hour rim lighting, photorealistic, shoulders-up, bright curious expression.
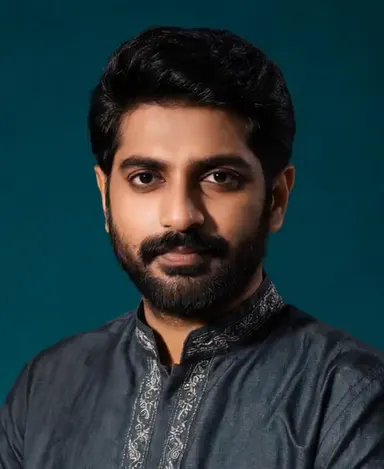 Infini Talk 5c
Studio portrait of a 38-year-old Indian man with neat beard, wearing a charcoal kurta with subtle embroidery, deep teal backdrop, split studio lighting, photorealistic, shoulders-up, composed and attentive expression.
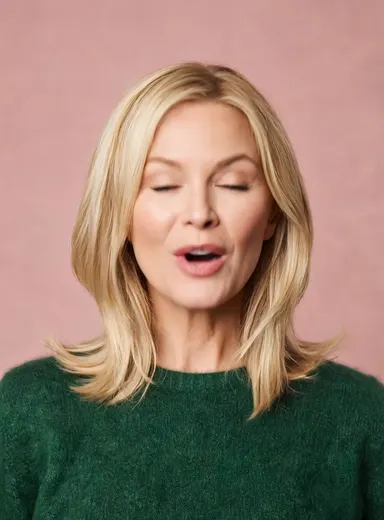 Fabric 1.0 2c
Studio portrait of a 45-year-old Swedish woman with blonde lob haircut, wearing a forest-green cashmere sweater, dusty rose backdrop, soft beauty-dish lighting, photorealistic, shoulders-up, genuine warm gaze.
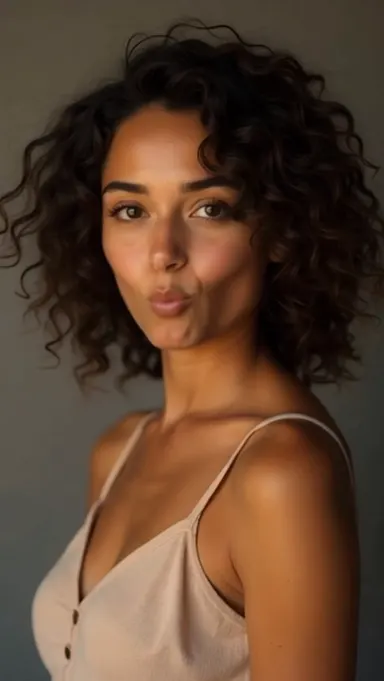 Sync-3 Lipsync 3c
Studio portrait of a 32-year-old South Korean man with undercut hair, wearing a crisp sky-blue dress shirt, off-white backdrop, cool cinematic LED lighting, photorealistic, shoulders-up, relaxed professional expression.
 SadTalker 8c
Studio portrait of a 55-year-old Brazilian woman with silver curls, wearing a deep burgundy turtleneck, slate-grey backdrop, soft front-fill studio lighting, photorealistic, shoulders-up, thoughtful neutral expression.
Sådan fungerer det
Giv ansigtet
Upload en video til dubbing eller et enkelt portræt til animering. Ansigter, der vender fremad, er velbelyst og har munden tydeligt synlig, synkroniseres mest overbevisende.
Tilføj lyden
Upload en optagelse, eller generer tale først i lydstudiet med tekst-til-tale eller en kloneret stemme. Modellen kortlægger hver talesound til den tilsvarende mundform.
Generer den synkroniserede video
Modellen regenererer mundregionen billede for billede eller animerer hele ansigtet fra fotoet, så læberne, kæben og udtrykkene bevæger sig i takt med lyden.
Modeller du kan bruge lige nu
Hver model nedenfor er live på Arteza med dens aktuelle kreditomkostning, hentet fra den samme prisberegningsmotor, som studiet bruger ved genereringstidspunktet.
Kling Avatar v2
Versatile lip sync for any character
fra 2 kreditter
Ofte stillede spørgsmål
Kan jeg lip synce et foto, eller har jeg brug for en video?
Begge arbejdsgange understøttes. Sync-3 Lipsync dubber eksisterende videoer med nyt lydspor op til 4K. OmniHuman v1.5, Kling Avatar v2 og Infini Talk animerer et enkelt foto plus en lydfil til en komplet talende video.
Fungerer AI lip sync på ethvert sprog?
Generelt ja. Modellen kortlægger lyde til mundformer snarere end at forstå ordene, så den kan synkronisere munde til de fleste talesprog, hvilket er grunden til, at lip sync er grundlaget for videooversættelse og lokaliseret indhold.
Hvilke input giver de bedste resultater?
Ren talelyden uden tung musik og et ansigt, der er rimelig stort, vender fremad og er uobstrueret. Hurtige hovedvendinger, hænder over munden og ekstreme vinkler er hvor artefakter opstår.
Kan jeg bruge andres ansigt?
Kun med deres samtykke. Lip sync bruges bredt til legitim dubbing, oversættelse og avatar-indhold, men du bør kun animere ligheden af personer, der har accepteret det.